Mostrando entradas con la etiqueta cache. Mostrar todas las entradas

jueves, 4 de febrero de 2021

WSO2 y Redis

Ya estuvimos hablando en un post anterior de WSO2 y el cache mediator. Hoy veremos una solución alternativa pero similar. En este caso utilizaremos Redis, que nos permitirá cachear la respuesta de un backend. 

Redis es un almacén de estructura de datos de valores de clave en memoria rápido y de código abierto. Básicamente una base de datos nosql de tipo clave y valor, muy popular entre los desarrolladores. Redis, permite el uso de diferentes tipos de datos: List, Sets, Hashes, etc. 

Nosotros nos basaremos únicamente en los pares clave-valor, los hashes. Y veremos su uso a través de un ejemplo, como siempre. En este ejemplo llamaremos a un backend y almacenaremos su respuesta asociado al identificador del objeto. Lo cual nos permitirá que al volver a llamar con el mismo identificador, devolver la respuesta anteriormente obtenida. 

Para empezar, usaremos un WSO2 EI 6.5.0. Con la versión standalone no es posible conectarse a Redis, para conseguirlo debemos hacer dos cosas:

  • Añadir la librería Jedis (2.10.2) en la carpeta ${WSO2_HOME}/lib y arrancar el servidor. 
  • Añadir el conector de Redis a través de la interfaz gráfica.  

El conector se puede obtener desde el WSO2 Store, y hay distintas versiones en función del producto que utilicemos. Hay que recordar que una vez después de añadirlo es necesario habilitarlo.


La forma más sencilla de utilizar Redis es como siempre utilizar docker, y para ello usaremos el siguiente comando:

docker run -p 6379:6379 --name redis -d redis

El uso del conector de Redis es similar al de otros conectores. Básicamente son custom mediators, que admiten múltiples propiedades y los cuales tienen nombres identificativos de las operaciones que realizan. 

Vamos a crear una API con varios recursos. En el primer recurso realizaremos los siguientes pasos:
  • Buscamos el identificador en Redis a través de la operación hExists. En la cual tenemos que incluir el volumen donde esta almacenado y su clave. 
  • Si existe la clave, utilizaremos la operación hGet con los mismos valores para recuperar el valor almacenado. 
  • Si no existe la clave, procederemos a llamar al backend. Posteriormente almacenaremos el valor a través de la operación hSet, en la cual indicaremos el volumen, la clave y el valor asociado. 
Además debemos tener en cuenta distintos aspectos del conector a tener en cuenta:
  • La primera vez que utilicemos el conector debemos invocar la operación init, la cual nos posibilitará la conexión a Redis. 
  • El resultado de la operación hExists se almacena en una propiedad de contexto denominada redisResponse. 
  • La operación hGet devuelve un valor true o false en base a si encuentra o no el resultado.
  • Debemos almacenar y restaurar el payload al utilizar la operación hSet para evitar devolver el resultado de la misma al cliente. 
<resource methods="GET" uri-template="/{bookId}">
    <inSequence>
        <property name="bookId" expression="$ctx:uri.var.bookId"/>
        <redis.init>
            <redisHost>localhost</redisHost>
            <redisPort>6379</redisPort>
            <redisTimeout>500</redisTimeout>
        </redis.init>
        <redis.hExists>
            <redisKey>Library</redisKey>
            <redisField>{$ctx:bookId}</redisField>
        </redis.hExists>
        <filter source="$ctx:redisResponse" regex="true">
            <then>
                <redis.hGet>
                    <redisKey>Library</redisKey>
                    <redisField>{$ctx:bookId}</redisField>
                </redis.hGet>
            </then>
            <else>
                <call>
                    <endpoint>
                        <http method="GET" uri-template="http://localhost:57001/book/{uri.var.bookId}"/>
                    </endpoint>
                </call>
                <enrich>
                    <source type="body" clone="false"/>
                    <target type="property" property="ORIGINAL_PAYLOAD"/>
                </enrich>
                <redis.hSet>
                    <redisKey>Library</redisKey>
                    <redisField>{$ctx:bookId}</redisField>
                    <redisValue>{$ctx:ORIGINAL_PAYLOAD}</redisValue>
                </redis.hSet>
                <enrich>
                    <source type="property" clone="false" property="ORIGINAL_PAYLOAD"/>
                    <target type="body"/>
                </enrich>
            </else>
        </filter>
        <property name="ContentType" scope="axis2" type="STRING" value="application/json"/>
        <respond/>
    </inSequence>
</resource>

A diferencia del cache mediator, con el conector de Redis podremos borrar un valor almacenado. Y esto es gracias a que el conector contiene múltiples operaciones. 

<resource methods="DELETE" uri-template="/{bookId}">
    <inSequence>
        <property name="bookId" expression="$ctx:uri.var.bookId"/>
        <redis.init>
            <redisHost>localhost</redisHost>
            <redisPort>6379</redisPort>
            <redisTimeout>500</redisTimeout>
        </redis.init>
        <redis.hDel>
            <redisKey>Library</redisKey>
            <redisFields>{$ctx:bookId}</redisFields>
        </redis.hDel>
        <respond/>
    </inSequence>
    <outSequence/>
    <faultSequence/>
</resource>

Este es un ejemplo muy básico, en nuestra integración podemos realizar diferentes llamadas y lógicas más complicadas para luego almacenar ese valor en base a un identificador. Esto nos puede llevar a mejorar mucho el rendimiento de nuestras integraciones. 

lunes, 11 de enero de 2021

WSO2 Mediator Tutorial: Como usar la cache

Hoy vamos a volver a post sobre WSO2 y sus mediadores. Veremos como funciona el Cache Mediator, el cual puede ser muy util aunque no es muy conocido. 

La idea es sencilla, a través de este mediador, WSO2 cacheará la respuesta de un backend determinado en base a la petición que vayamos a hacer. ¿Como lo hace? Obtiene un valor hash asociado al mensaje almacenado en el flujo. Si existe ejecutará la secuencia configurada en el parámetro onCacheHit, el cual es opcional, obtiene la respuesta almacenada en el cache y envía la respuesta. Si no existe, se realiza la llamada al backend y se almacena la respuesta para su posible uso futuro. 

Vamos a ver un ejemplo sencillo de su uso. Vamos a crear un recurso de una API que llame a un backend, hecho con Wiremock, y antes del cual configuraremos el Cache Mediator para su uso. En el mediador configuraremos varias cosas aparte de las que vienen por defecto. Como son que la cache se mantenga durante 20 segundos, que solo cachee las llamadas de métodos POST y que como mucho almacene 10 elementos en la cache. 

<resource methods="POST" url-mapping="/sample1">
    <inSequence>
        <property name="REST_URL_POSTFIX" scope="axis2" action="remove"/>
        <cache collector="false" timeout="20">
            <onCacheHit>
                <log level="custom">
                    <property name="testing" value="Cache Hit"/>
                </log>
                <respond/>
            </onCacheHit>
            <protocol type="HTTP">
                <methods>POST</methods>
                <headersToExcludeInHash/>
                <responseCodes>.*</responseCodes>
                <enableCacheControl>false</enableCacheControl>
                <includeAgeHeader>false</includeAgeHeader>
                <hashGenerator>org.wso2.carbon.mediator.cache.digest.DOMHASHGenerator</hashGenerator>
            </protocol>
            <implementation maxSize="10"/>
        </cache>
        <send>
            <endpoint>
                <http method="POST" uri-template="http://localhost:57001/sample1"/>
            </endpoint>
        </send>
    </inSequence>
    <outSequence>
        <cache collector="true"/>
        <respond/>
    </outSequence>
</resource>

A continuación realizaremos una invocación a la API y la primera vez veremos como el Wiremock es invocado, y cuando volvemos a llamar una segunda vez no. 

curl --location --request POST 'http://localhost:8280/cache/sample1' \
--header 'Content-Type: application/json' \
--data-raw '{}'

Como veis en el ejemplo, el uso de cache mediator se divide en dos partes. Por un lado la configuración de la propia cache antes de llamar al backend y por otro lado una nueva invocación a la misma pero para indicar que nos devuelva el valor asociado a la misma si es que hay. En esta segunda invocación no es necesario configurar nada, solo indicar a true el parámetro collector. 

El cache mediator también puede ser utilizado para llamadas al backend a través del call mediator. En el caso de que decidamos que queremos usarlo así, tendremos que indicar a Synapse despues de la llamada al backend, que nos encontramos tratando con un mensaje de respuesta. Esto lo haremos a través de la propiedad RESPONSE. Sin esa propiedad, en este ejemplo, el cache mediator no funcionará. 

<resource methods="POST" url-mapping="/sample2">
    <inSequence>
        <property name="REST_URL_POSTFIX" scope="axis2" action="remove"/>
        <cache collector="false" timeout="20">
            <protocol type="HTTP">
                <methods>POST</methods>
                <headersToExcludeInHash/>
                <responseCodes>.*</responseCodes>
                <enableCacheControl>false</enableCacheControl>
                <includeAgeHeader>false</includeAgeHeader>
                <hashGenerator>org.wso2.carbon.mediator.cache.digest.DOMHASHGenerator</hashGenerator>
            </protocol>
            <implementation maxSize="10"/>
        </cache>
        <call>
            <endpoint>
                <http method="POST" uri-template="http://localhost:57001/sample1"/>
            </endpoint>
        </call>
        <property name="RESPONSE" value="true" scope="default" type="STRING"/>
        <cache collector="true"/>
        <respond/>
    </inSequence>
    <outSequence />
</resource>

Como veis es muy sencillo de usar y no requiere de apenas configuración. Por ponerle alguna pega, podriamos decir que no cuenta de un método que permita borrar la cache para un determinado mensaje, por lo que en caso de que la respuesta no valiese ya, solo podría ser cambiada una vez que se dicha cache se caducase. 

viernes, 20 de noviembre de 2020

Apache Camel: Uso de Cache con Caffeine

Hoy vamos a ver como mejorar el rendimiento de nuestros web services en Apache Camel. Para ello usaremos Caffeine Cache, una sencilla pero potente cache en memoria realizada en Java y basada en la cache de Guava.

La idea detras del uso del cache, será poder almacenar el resultado de operaciones costosas en memoría. De esta forma, en sucesivas llamadas podremos acceder a dicho resultado de forma rápida y agil evitando la operación más costosa. 

Empecemos como siempre indicando cuales son las librerías a incluir. Por un lado la propia dependencía para usar Caffeine y por otro el starter de Spring que nos provee de una configuración por defecto. 

<dependency>
  <groupId>org.apache.camel.springboot</groupId>
  <artifactId>camel-caffeine-starter</artifactId>
</dependency>
<dependency>
  <groupId>org.apache.camel</groupId>
  <artifactId>camel-caffeine</artifactId>
</dependency>

¿Como funciona? Debemos pensar en la cache como su fuera un ConcurrentMap. Es decir, iremos colocando objetos asociados a una clave determinada y a través de esa clave podremos recuperarlos. Por tanto para poder usarlo, usaremos acciones del tipo GET o PUT asociados a una clave. El cuerpo del mensaje será el objeto almacenado en la cache. 

Cuando realicemos alguna operación Caffeine nos indicará si dicha operación ha resultado exitosa y si hay algún resultado asociado a la misma. Esta información nos la dará a través de valores almacenados en la cabecera: CamelCaffeineActionSucceeded y CamelCaffeineActionHasResult. Caffeine también tiene una interface, denominada CaffeineConstants, con todas las constantes asociadas a sus operaciones o resultados que nos puede ayudar en el desarrollo. 

A continuación veremos el ejemplo para obtener un libro en base a su identificador. El identificador nos servirá como clave para almacenar el libro asociado en la cache. Primero comprobaremos si se encuentra en la cache (acción GET), en dicho caso devolveremos el valor asociado. En caso contrario realizaremos la operación de consulta a base de datos y almacenaremos el resultado en la cache (acción PUT) para futuras consultas. 

rest().get("cache/book/{id}")
.description("Details of an book by id").outType(Book.class)
.produces(MediaType.APPLICATION_JSON_VALUE).route()
.log("Cache : Select Book By Id: ${header.id}")
.setHeader(CaffeineConstants.ACTION, constant(CaffeineConstants.ACTION_GET))
.setHeader(CaffeineConstants.KEY, header("id"))
.toF("caffeine-cache://%s", "BookCache")
.log("Has Result ${header.CamelCaffeineActionHasResult} ActionSucceeded ${header.CamelCaffeineActionSucceeded}")
.choice().when(header(CaffeineConstants.ACTION_HAS_RESULT).isEqualTo(Boolean.FALSE))
   .to("sql:{{sql.selectById}}")
   .setHeader(CaffeineConstants.ACTION, constant(CaffeineConstants.ACTION_PUT))
   .setHeader(CaffeineConstants.KEY, header("id"))
   .toF("caffeine-cache://%s", "BookCache")
.otherwise()
   .log("Cache is working");

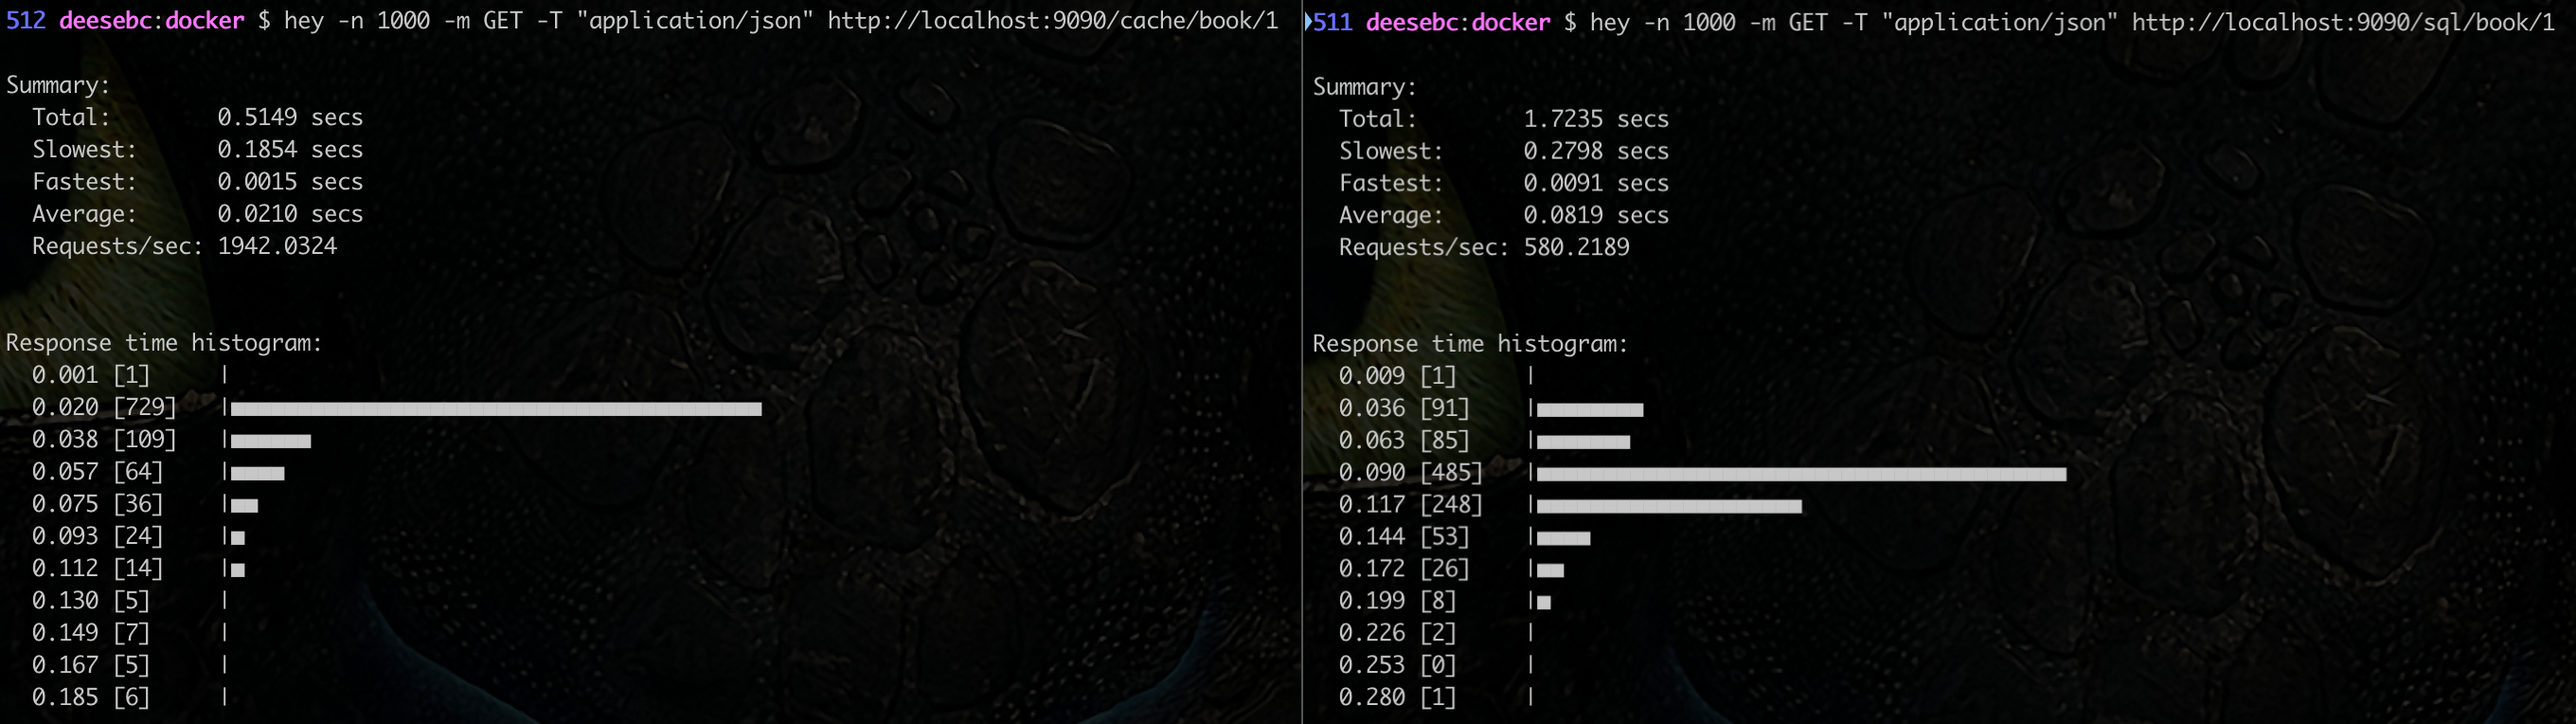
Si hacemos una prueba, comprobaremos que los tiempos y el rendimiento con Caffeine son mejores. Si lo comparamos usando hey, aún siendo una operación muy básica vemos como los tiempos se reducen mucho:


Pero tenemos que tener en cuenta que pasaría si el resultado de esa operación costosa cambiase. En dicho caso la cache seguría funcionando y devolviendo un valor erróneo. Para evitar eso tenemos, tenemos dos opciones. Primera opción a través de la configuración, con la cual podremos modificar cuántos resultados y cuanto tiempo se mantendrán en memoría. 

O una segunda opción, que será directamente invalidar manualmente la cache de un determinado objeto. Por ejemplo, en el caso de que borremos un objeto, no queremos que esa cache siga existiendo y devuelva resultados erróneos. Esto podremos hacerlo a través de la acción INVALIDATE. 

rest().delete("cache/book/{id}").produces(MediaType.APPLICATION_JSON_VALUE)
.route().to("sql:{{sql.delete}}")
.setHeader(CaffeineConstants.ACTION, constant(CaffeineConstants.ACTION_INVALIDATE))
.setHeader(CaffeineConstants.KEY, header("id"))
.toF("caffeine-cache://%s", "BookCache")
.setHeader(Exchange.CONTENT_TYPE, constant(MediaType.APPLICATION_JSON_VALUE))
.setHeader(Exchange.HTTP_RESPONSE_CODE, constant(200)).setBody(constant(null));

Por último vamos a ver la opción de como debería comportarse una aplicación cuando se actualiza el objeto cacheado. La solución fácil sería invalidar la cache asociada a la clave y volver a cachearlo cuando sea invocado de nuevo. Pero esta opción nos hará realizar una operación costosa más, de las necesarias. Si ya tenemos el objeto podríamos simplemente almacenarlo de nuevo en la cache y evitar esa futura operación costosa. Ejemplo con el método PUT. 

rest().put("cache/book/{id}").produces(MediaType.APPLICATION_JSON_VALUE)
.type(Book.class).route()
.choice().when().simple("${header.id} < 1")
   .bean(BookSQLRouter.class, "negativeId")
.otherwise()
   .log("PUT : Body: ${body}")//${body[id]
   .to("sql:UPDATE BOOK SET NAME = :#${body.name}, AUTHOR = :#${body.author} WHERE ID = :#id")
   .process(exchange -> {
       final Book book = exchange.getIn().getBody(Book.class);
       book.setId(Integer.valueOf(exchange.getIn().getHeader("id").toString()));
    })
   .setHeader(CaffeineConstants.ACTION, constant(CaffeineConstants.ACTION_PUT))
   .setHeader(CaffeineConstants.KEY, header("id"))
   .toF("caffeine-cache://%s", "BookCache")
   .setHeader(Exchange.HTTP_RESPONSE_CODE, constant(200))
   .setBody(constant(null));

Como siempre podeis ver el código completo aquí. 

miércoles, 4 de enero de 2017

Como actualizar datos de la Cache con Spring Boot

Ya en un post anterior hablamos de como realizar la configuración básica con Spring Boot para cachear consultas de BBDD.

Con este ejemplo cuando hacemos una consulta de BBDD ya tenemos almacenado su valor en memoria y accederemos al mismo de forma rápida en futuras consultas. ¿Pero que pasa si por alguna razón los valores cacheados son cambiados en BBDD?

Ya indicamos que cada consulta de BBDD será identificada con un nombre, el cual indicamos en la propia anotación 'Cacheable', cuya representación será un mapa de valores en memoria. Ese mapa de valores estará formado por parejas clave/valor, donde la clave es el parámetro de entrada y el valor el resultado de la consulta original.

Si lo hacemos a través de nuestras clases DAO no tendremos problema. Y para ello haremos uso de la anotación @CachePut. Esta anotación nos permitirá actualizar un mapa de valores concreto y dentro de ese mapa que clave/valor. Esto lo haremos con las propiedades 'cacheNames' y 'key' respectivamente. Un ejemplo:

@Cacheable( value = { "CountryDao.findByCode" } )
Country findByCode( @Param( "code" ) String code );

@CachePut( cacheNames = "CountryDao.findByCode", key = "#p0.code" )
Country update( S entity );

Otra opción posible es borrar directamente ese mapa de valores. Bien porque se quiera liberar memoria, sean datos que ya no se usan o alguna otra causa.

@CacheEvict( cacheNames = { "CountryDao.findByCode" }, key = "#p0.code" )
Country save( S entity );

Esta anotación además permite el borrado de todas las parejas clave/valor de un determinado mapa. Para ello debemos usar la propiedad 'allentries'.


@CacheEvict(cacheNames="CountryDao.loadCountries", allEntries=true)
public void loadCountries()

miércoles, 7 de diciembre de 2016

Habilitar y usar la Cache con Spring Boot

Ya realice hace no mucho un post sobre como usar la cache con una aplicación Spring, hoy veremos como hacerlo con una aplicación Spring Boot. Haremos un ejemplo básico, utilizando la configuración por defecto de Spring Boot sin hacer uso de software de terceros como Ehcache.

Para empezar suponemos que tenemos una aplicacion correctamente configurada respecto a Spring Boot y el acceso a BBDD. Lo primero que tendremos que hacer es añadir la librería que nos permite habilitar la cache

<dependency>
 <groupId>org.springframework.boot</groupId>
 <artifactId>spring-boot-starter-cache</artifactId>
</dependency>

El siguiente paso, será indicar en nuestra clase de configuración indicar mediante la anotación 'EnableCaching' que vamos a utilizar la cache de consultas a BBDD. Con esta anotación, al arrancar Spring buscará en todas las clases las anotaciones  Cacheable, CachePut y CacheEvict.

@Configuration
@EnableWebMvc
@EnableCaching
public class WebMvcConfig extends WebMvcConfigurerAdapter {

Por último solo deberemos indicar en las llamadas a BBDD cuales van a ser cacheadas.


@Cacheable( value = { "CountryDao.findByCode" } )
Country findByCode( @Param( "code" ) String code );

Cuando cacheamos una consulta verdaderamente estamos haciendo un almacenamiento de los resultados en un mapa de memoria. Para poder diferenciar los diferentes mapas de datos en memoria cacheados utilizamos el campo 'value' asociado a la anotación 'Cacheable'.